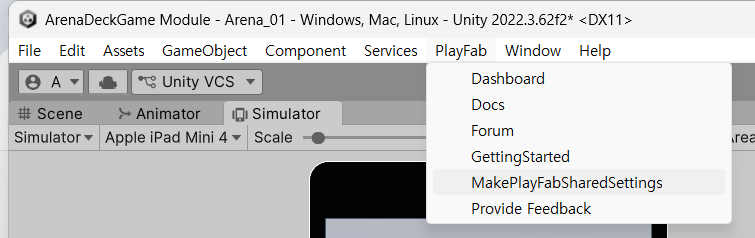
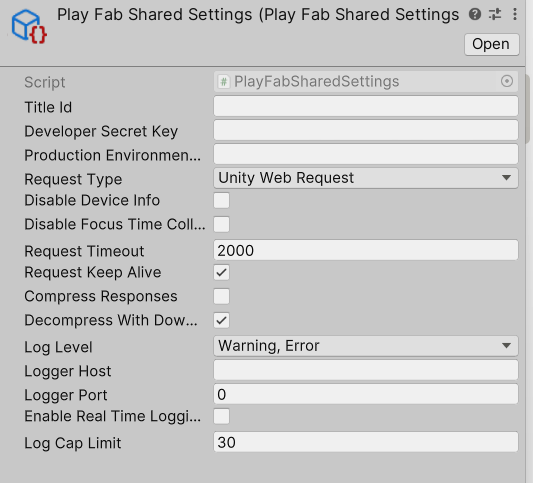
PlayFab ➔ Make PlayFab Shared Settings를 클릭하여 설정 창을 열고, 아까 복사해 둔 Title ID를 붙여넣어 에디터와 서버를 연결합니다.
1. Production Environment Url (운영 환경 URL)
어떤 설정인가요?Microsoft PlayFab Game Manager에서 생성한 내 타이틀(프로젝트)의 전용 서버 API 주소입니다. 기본적으로 비워두면 SDK가 알아서 기본 주소(https://[TitleId].playfabapi.com)를 찾아가지만, 별도의 프록시 서버나 커스텀 라우팅을 거쳐야 하는 특별한 대규모 운영 환경이 아니라면 보통 비워두거나 기본값으로 둡니다.
입력 예시: 필요 시 커스텀 API 엔드포인트 주소를 입력합니다.
2. Request Type (요청 타입)
어떤 설정인가요? 클라이언트 앱이 PlayFab 서버와 통신할 때 내부적으로 어떤 네트워크 라이브러리를 사용할지 결정하는 옵션입니다. []
추천 설정:Unity Web Request (또는 드롭다운에서 가장 대중적인 기본 옵션 선택)
Unity Web Request: 유니티 엔진에 가장 최적화되어 있고 에러가 적어 마이크로소프트 공식 문서에서도 강력하게 권장하는 기본 방식입니다.
Http Web Request: C# 표준 라이브러리 방식입니다. 특별한 구버전 호환성이 필요한 게 아니라면 굳이 선택하지 않습니다.
Custom Http: 네트워크 모듈을 직접 커스텀하여 패킷을 보낼 때만 사용합니다.
이거 입력후에 다시 들어가면 다 빈칸으로 초기화되어있던데 왜 그런걸까?
💡 한 줄 요약 Production Environment Url은 특별한 세팅이 없다면 그냥 비워두시고, Request Type은 Unity Web Request로 선택하시는 것이 가장 안전하고 일반적인 세팅입니다
Step 3. 클라이언트 통신 코드 작성
환경 세팅이 끝났으므로, 유니티가 PlayFab 라이브러리를 정상적으로 인식합니다.
PlayFabManager 스크립트를 작성하고 빈 게임 오브젝트에 컴포넌트로 붙입니다.
게임을 플레이(Play)하여 콘솔 창에 로그인 성공 로그가 뜨는지 확인합니다.
using UnityEngine;
using PlayFab;
using PlayFab.ClientModels;

public class PlayFabManager : MonoBehaviour
{
    private string customId = "TestUser_01";

    void Start()
    {
        var request = new LoginWithCustomIDRequest
        {
            CustomId = customId,
            CreateAccount = true
        };

        PlayFabClientAPI.LoginWithCustomID(request,
            result =>
            {
                Debug.Log("PlayFab 로그인 성공! 부여받은 고유 ID: " + result.PlayFabId);
            },
            error =>
            {
                Debug.LogError("PlayFab 로그인 실패: " + error.GenerateErrorReport());
            }
            );
    }
}
(2) PlayFab 로그인 실패 로그가 뜬다면
/Client/LoginWithCustomID: Player creations have been disabled for this API
해결 : Allow client to start player creation 체크
PlayFab Game Manager 로그인
해당 타이틀(프로젝트) 선택
왼쪽 아래 Title settings (톱니바퀴 아이콘) 클릭
Client Profile Options (또는 Login settings) 탭 이동
Allow client to start player creation 항목 체크 후 저장
이 에러는 PlayFab 타이틀 설정에서 새로운 유저 회원가입(계정 생성) 기능이 비활성화되어 있기 때문에 발생합니다. LoginWithCustomID API는 기본적으로 기존 계정이 없으면 새 계정을 자동으로 생성(CreateAccount = true)하려고 시도하는데, 서버가 이를 막아둔 상태입니다.
이를 해결하기 위한 두 가지 방법입니다.
1. PlayFab 게임 매니저(대시보드) 설정 변경
새로운 플레이어가 가입할 수 있도록 서버 설정을 켜야 합니다.
2. 유니티 코드 확인 (기존 계정 로그인 시)
만약 회원가입을 막아둔 것이 의도된 기획이라면, 코드에서 새 계정을 생성하지 않도록 설정을 바꿔야 에러를 깔끔하게 예외 처리할 수 있습니다.
var request = new LoginWithCustomIDRequest {
    CustomId = "UniquePlayerID",
    CreateAccount = false // 새 계정 생성을 막음 (기존 유저만 로그인 가능)
};
18446744073709551615 라는 출력값이 string::npos 값이라고 보면 됨. 환경에 따라 값이 다를 수 있음.
size_t
보통 컨테이너나 문자열의 크기 및 인덱스 표현할 때 사용
size_t pos1 = str.find("Hello"); 에서는 "Hello"를 찾아서 0을 반환했지만
size_t pos3 = str.find("Hello", start_index); 에서는 find() 메서드의 탐색 시작 위치가 달라 문자열을 찾지 못해 string::npos 반환.
문자열 추가, 수정
문자열 추가는 '+' 연산자 혹은 '+=' 연산자를 사용.
특정 문자를 수정하려면 '[]' 연산자를 활용해 임의 접근 후 수정하거나 replace(0 메서드 활용.
replace() 메서드
3개의 인수를 받음. 순서대로 시작 위치, 시작 위치부터 몇 개의 문자열을 대체할 것인지, 대체할 문자열을 의미.
즉 첫 인수와 두 번째 인수로 주어진 범위 내 문자열이 세 번째 인수로 받은 문자열로 대체됨.
replace() 메서드 시간 복잡도는 대체할 문자열의 길이가 N일 때 O(N).
#include <iostream>
#include <string>

using namesapce std;

int main() {
string str = "APPLE";
str += ", World!"; // (1) 문자열 추가
cout << str << endl; // "APPLE, World!" 출력

// 문자열 수정
str[7] = 'P'; // (2) 7번째 문자 W -> P로 수정
cout << str << endl; // "APPLE, Porld!" 출력

str.replace(7, 4, "Col"); // (3) 7번째 문자부터 'col'로 변경
cout << str << endl; // "APPLE, Cold!" 출력

return 0;
}
(3) replace() 메서드로 7번째 위치부터 4개의 문자열을 "Col"로 변경.
즉 변경할 기존 문자열과 똑같은 개수의 문자를 바꾸는 게 아니라, 변경 범위를 지정 후 바꿀 문자열로 대체되는 것임.
__04-2 STL + NET 컬렉션과 LINQ (C++의 STL에 대응)
__C++
STL (standrad template library)
C++에서 제공하는 템플릿 기반 표준 라이브러리.
템플릿 = C++에서 함수나 클래스 구현 시 어떤 타입에서도 동작하도록 하는 문법
따라서 STL 역시 특정 타입에 한정하지 않고 라이브러리를 사용할 수 있음.
STL은 크게 데이터를 담을 수 있는 컨테이너(Container), 데이터를 처리하고 제어할 수 있는 여러 가지 알고리즘(algorithm), 컨테이너에 접근 및 순회할 수 있게 하는 반복자(iterator) 로 이루어져 있음.
(STL 문법은 아니지만 )STL과 자주 사용하는 필수 문법
상수 레퍼런스
복사값과 참조값을 전달하는 방식의 차이
C++, C# 에서는 함수의 인수로 값을 전달할 때 값을 복사함. = call by balue
함수가 호출될 때마다 함수의 인수로 값이 전달되면서 복사 비용이 듬.
함수의 인수로 STL 컨테이너같은 객체 혹은 구조체 등을 넘길 때 이 복사 비용이 성능에 영향을 줄 수 있음.
#include <iostream>

using namespace std;

void modify(int value) {
 value = 10; // (2) 새 공간의 value 변경
 cout << "주소 " << &value << endl; // 주소 : 0x7fff84f16e5c
 cout << "값 : " << value << endl; // (3) 변경한 값 출력 / 값 : 10
 // (4) 함수가 종료되면 modify() 함수의 value는 메모리에서 사라짐
}

int main() {
 int value = 5;
 cout << "주소 : " << &value << endl; // 주소 : 0x7fff84f16e74
 cout << "값 : " << value << endl; // 값 : 5
 modify(value); // (1) modify() 함수 호출
 cout << "값 : " << value << endl; // (5) main() 함수 value 값은 그대로 / 값 : 5

 return 0;
 }
실제 값이 바뀌어야 하는 경우
예) 크기가 1,000만인 정수형 배열을 포함한 객체' 처럼 규모가 큰 객체를 함수의 인수로 넘길 때
이 경우, 굳이 객체 전체를 복사하지 않고 레퍼런스를 활용해서 넘기기도 함. = call by reference(참조에 의한 호출) 방식.
레퍼런스는 &라는 문법 사용. 이를 활용하면 변수 자체를 복사하지 않고 참조자를 통해 변수에 접근하고 수정 가능.
#include <iostream>

using namespace std;

void modify(int& value) {
	value = 10; // (2) main() 의 value값 자체 변경
    cout << "주소 " << &value << endl; // 주소 : 0x7fff6272fc34
    cout << "값 : " << value << endl; // 값 : 10
}

int main() {
	int value = 5;
    cout << "주소 : " << &value << endl; // 주소 : 0x7fff6272fc34
    cout << "값 : " << value << endl; // 값 : 5
    modify(value); // (1) modify() 함수 호출
    cout << "값 : " << value << endl; // (3) main() 함수 value 값 변경 / 값 : 10

    return 0;
}
(2)에서 (1)에서 참조값으로 받은 value(5)를 10으로 수정
*참조값 전달과 주소값 전달의 공통점과 차이점은?
참조값(레퍼런스 사용)이 아니라 주소값을 전달(포인터 사용)하여 함수 호출 시 전달된 인수를 수정하는 방식도 있음.
공통점
- 실 인수값을 변경 가능 = 해당 목적에서는 차이가 없다
차이점
= 포인터 문법을 사용하냐 마냐.
- 참조값 전달 시 참조 변수와 참조 대상 변수의 주소값이 일치하므로 메모리의 값을 읽고 쓰기 위한 추가 문법이 불필요.
- 주소값을 전달하면 주소값을 전달받은 변수의 주소와 실제 변수의 주소값이 다름. 그래서 주소값을 받기 위한 포인터 변수를 사용해야함.
다만, 포인터 문법 사용 시 2가지 불편함이 생김.
(1) 포인터를 사용하면 의도치 않은 예외가 발생할 수 있음. 예) 잘못된 주소 접근
(2) 포인터 문법은 간접 참조를 하므로 주소를 얻을 때와 값을 얻을 때의 문법이 다름. 상대적으로 포인터의 문법이 좀 더 복잡함.
출처 Google 검색 Gemini 답변
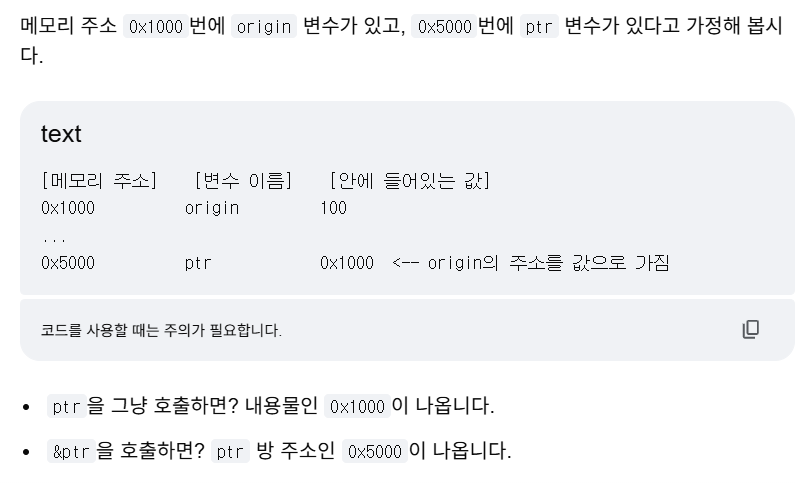
Q. 주소값은 main 의 origin을 원본으로 하고, 포인터가 가리키는 ptr 자체의 주소는, main이 아니라 포인터 함수 안에서만 존재하기 때문에 origin의 참조를 저장한 ref의 주소와 별개인가? 만약 origin과 같은 코드블록에서 저장된 포인터라면 같은 메모리 공간을 가질 수 있는지?
X. 같은 코드 블록에 있더라도 포인터 변수 자체의 주소(&ptr)는 원본 변수의 주소(&origin)와 결코 같아질 수 없음.
int origin = 100;
int* ptr = &origin; // main 함수 안에 같이 선언

// 결과: ptr 자체의 주소(&ptr)와 origin의 주소(&origin)는 다릅니다.
// ptr이라는 방[ 0x7fff... ] 안에 origin의 주소값(0x7fff...)을 글자로 적어둔 것과 같습니다.
애초에 포인터 = 주소값을 저장하기 위한 독립적인 변수임. 반면 참조자(ref, &)는 새 변수를 만들지 않고 기존 변수에 새 이름(별명)만 붙이는 개념. 따라서 같은 블록이든 함수 내부든 상관없이 &ref를 출력하면 무조건 원본 &origin과 일치함.
근데 나는 아래와 같은 의문이 들어서, 좀 더 원리를 정확하게 이해하고 싶었음.
*ptr (역참조 Dereference 연산자)의 원리
= 변수 ptr에 저장된 주소를 통해 원본 origin에 접근하게 해주는 문법
참조자(Reference)는 메모리에 어떻게 저장될까?
Q. 메모리 공간이 나뉘어 있는데 참조는 어디에 어떻게 저장되는가?
참조자는 메모리에 자기 공간을 만들지 않는다. 이것이 포인터와의 가장 큰 차이점.
컴파일러의 비밀 (기호 테이블)
프로그램이 실행될 때, 컴퓨터 내부에는 변수의 이름과 주소를 매핑해두는 '기호 테이블(Symbol Table)'이라는 지도가 생성됨
int origin = 100;
int& ref = origin; // 참조자 선언
위 코드가 컴파일되면 내부 지도는 다음과 같이 작성됨.
[이름] [가리키는 실제 메모리 주소] origin --> 0x1000 ref --> 0x1000 (새 공간을 파지 않고, 똑같은 주소를 가리킴)
즉, 참조자 ref는 메모리 상에 ptr처럼 0x5000 같은 새로운 방을 전혀 만들지 않음. 그저 0x1000이라는 동일한 방에 'origin'이라는 이름표 외에 'ref'라는 이름표를 하나 더 붙인 것뿐임. 그렇기 때문에 &ref를 하면 ref 자체의 주소가 나오는 게 아니라, 이름표가 붙어있는 실제 방 주소인 0x1000이 나오게 되는 것.
Q. 포인터와 참조자의 성능 차이?
실제 실행 성능(속도와 메모리) 차이는 거의 없음.
C++ 컴파일러는 내부적으로 참조자(&)를 포인터(*)와 똑같은 방식으로 기계어로 변환함.
기계어 관점에서는 참조자도 결국 원본의 주소를 참조하여 값을 찾아가기 때문에, 두 방식 모두 동일한 속도로 작동하도록 레지스터가 최적화 되어있음.
Q. 상황별 사용 기준?
기능과 성능이 비슷하다면, 기본적으로 참조자를 쓰고 꼭 필요할 때만 포인터를 씀.
참조자(Reference)를 써야 하는 경우
안전하고 깔끔한 코드가 필요할 때: 가독성이 좋고 nullptr 에러 위험이 없음.
함수 매개변수로 객체를 넘길 때: void print(const MyClass& obj) 처럼 복사 비용을 줄이면서 안전하게 읽기 전용으로 넘길 때 사용.
연산자 오버로딩을 할 때: cout << a; 처럼 연속적인 연산자 문법을 유지해야 할 때 필수적.
포인터(Pointer)를 반드시 써야 하는 경우
대상을 바꾸어야 할 때 (재할당): 참조자는 한번 누군가의 별명이 되면 대상을 바꿀 수 없음. 가리키는 대상을 이리저리 바꾸어야 한다면 포인터가 필수.
"아무것도 없음"을 표현해야 할 때: 값이 없을 수도 있는 상태(nullptr)를 다루어야 한다면 포인터만 가능. (참조자는 빈 값을 가질 수 없음.)
동적 할당을 할 때: new 연산자를 통해 힙(Heap) 메모리에 공간을 만들고 주소를 받아올 때는 포인터를 사용해야 함.
그 외 자세하게 궁금하고 정리할 내용이 많아서 따로 게시물 팔 생각임.
auto문
STL은 어떤 타입이라도 사용할 수 있도록 잘 구현되어 있지만, 타입 복잡해지면 사용할 때 실수하기 쉽고 코드도 길어지므로 가독성이 떨어질 수 있음. 이때 auto 키워드를 사용하면 변수의 타입을 자동으로 추론하기 때문에 유지보수가 쉬워진다함.
#include <iostream>
#include <vector>
#include <map>
#include <string>

using namespace std;

int main() {
 auto num = 42; // int로 추론
 auto pi = 3.14159 // double로 추론
 auto greeting = string("Hello, world!"); // string으로 추론

 return 0;
}
범위 기반 반복문
배열이나 컨테이너의 모든 원소를 순회할 때 사용. 기본 반복문보다 구현이 쉽고 가독성이 좋음.
#include <iostream>
#include <vector>

using namespace std;

// 빈 2차원 벡터 선언
vector<vector<int>> v1;

// 특정 크기로 초기화된 2차원 벡터
int rows = 3;
int cols = 4;
vector<vector<int>> v2(rows, vector<int>(cols)); // v2에는 쓰레기 값이 채워져 있음

// 특정 값으로 초기화된 2차원 벡터
int val = 9;
vector<vector<int>> v3(rows, vector<int>(cols, val));

// 초기화 리스트를 사용한 2차원 벡터 초기화
vector<vector<int>> v4 = {
  {1. 2. 3}.
  {4, 5, 6},
  {7, 8, 9}
};
벡터의 원소 변경
벡터에서 원소를 변경하는 방법은 여러 가지가 있지만, '[ ]' 연산자를 활용하는 방법만 알면 충분하다고 함.
방법은 배열과 완전히 같고 시간 복잡도는 O(1).
#include <iostream>
#include <vector>

using namespace std;

int main() {
  vector<int> vec = {1, 2, 3, 4, 5};

  // 인덱스 2의 원소를 10으로 수정
  vec[2] = 10;

  return 0;
}
벡터의 삽입과 삭제
벡터 내부는 배열로 구성되어 있음. 따라서 맨 뒤에서는 삽입, 삭제 연산을 효율적으로 할 수 있지만, 맨 앞에서 원소를 삽입, 삭제 연산을 할 때는 매우 비효율적임. 맨 앞의 원소를 삽입, 삭제하면 뒤의 원소들을 한 칸씩 이동해야 하기 때문임.
벡터에 데이터가 N개 있으면 해당 연산은 시간 복잡도가 O(N)이 됨. 만약 문제를 풀 때 벡터 활용으로 구현했는데 맨 앞 원소를 삽입, 삭제하는 일이 빈번하다면 다른 컨테이너로 접근 가능한지 고민해보는 게 좋다 함.
맨 앞 원소를 효율적으로 삽입, 삭제할 수 있는 자료구조는 덱(Deque)이 있으며 시간 복잡도는 O(1)임.
벡터로 맨 뒤에 원소를 삽입, 삭제하는 법
맨 뒤에 원소를 삽입할 때는 push_back(), 맨 뒤 원소를 삭제할 때는 pop_back() 메서드 활용.
내부가 배열로 구성되었으므로 맨 뒤의 삽입, 삭제는 저장된 다른 값에 전혀 영향을 미치지 않음.
따라서 이 두 메서드의 시간 복잡도는 O(1)임.
#include <iostream>
#include <vector>

using namespace std;

int main() {
  vector<int> v = {2, 3, 4, 5};

  // (1) 맨 뒤에 원소 삽입
  v.push_back(6);

  // (2) 맨 뒤의 원소 삭제
  v.pop_back();

  return 0;
}
맨 앞에 원소를 삽입할 때는 insert() 메서드를 활용하면 됨.
insert()는 첫 번째 인수로 원소를 삽입할 주소를, 두 번째 인수로 삽입할 값을 받음.
맨 앞 원소를 삭제할 때는 erase() 메서드를 사용함.
#include <iostream>
#include <vector>

using namespace std;

int main() {
  vector<int> v = {2, 3, 4, 5};

  // 맨 앞에 원소 삽입
  v.insert(v.begin(), 1); // v: {1, 2, 3, 4, 5}
  // 맨 앞의 원소 삭제
  v.erase(v.begin()); // v: {2, 3, 4, 5}

  return 0;
}
__셋
셋(set)은 중복을 허용하지 않고, 저장된 데이터를 자동으로 정렬하는 컨테이너. 집합이라고 표현하기도 함.
셋의 선언 및 초기화
셋을 사용하려면 #incldue <set>으로 셋 헤더를 포함시켜야 함.
#include <iostream>
#include <set>

using namespace std;

set<int> s1; // (1) 빈 셋 선언
set<int> s2 = {3, 1, 3, 2, 5}; // (2) 초기화 리스트를 사용한 셋 초기화
set<int> s3(s2); // 다른 셋을 사용하여 초기화
s2와 s3를 그림으로 나타내면 다음과 같음.
s2 [1][2][3][5]s3 [1][2][3][5]
그림을 보면 s2와 s3가 {3, 1, 3, 2, 5}가 아니라 {1, 2, 3, 5}임. 그 이유는 셋이 중복값을 허용하지 않기 때문임. 뿐만 아니라
셋은 원소를 대입할 때 동시에 내부에서 정렬을 수행하여 {1, 2, 3, 5}가 됨. 셋을 그림으로 표현할 때 배열처럼 표현했지만 실제로는 균형 이진 트리로 구성되어 있음. 여기서 정렬이 되었다는 의미는 배열처럼 작은 원소부터 메모리에 순차 저장된다는 의미가 아니라 트리 구조를 통해 정렬 상태를 유지한다는 의미임.
셋에서 원소 탐색
셋에 특정 원소가 있는지 확인하려면 find() 메서드를 사용함. 만약 찾는 원소가 있으면 원소의 위치를 반환하고 없으면 end 반복자를 반환함. 셋의 크기가 N일 때 find() 메서드의 시간 복잡도는 O(logN). (트리구조라서 그런 것 같음. 양쪽으로 경우의 수가 뻗어나가니까 탐색도 한번에 2배, 중복도 제외되고?)
#include <iostream>
#include <set>

using namespace std;

int main() {
  set<int> numbers = {1, 2, 3, 4, 5};
  int targets[] = {3, 7}; // 원소가 3과 7인 배열

  for (int target : targets) {
    // set에서 원소를 탐색하는 방법
    auto it = numbers.find(target);

    if (it != numbers.end()) {
      cout << "원소 " << target << "를 찾았습니다. 값: " << *it << endl;
      } else {
        cout << "원소 " << target << "를 찾지 못했습니다." << endl;
      }
    }

  return 0;
}
/*
  원소 3를 찾았습니다. 값: 3
  원소 7를 찾지 못했습니다.
*/
셋의 삽입과 삭제
벡터는 원소 위치에 따라 삽입, 삭제의 시간 복잡도 차이가 많이 났음. 하지만 셋은 모든 사입, 삭제의 시간 복잡도가 O(logN)임.
삽입, 삭제 후에도 정렬된 상태를 유지하기 때문. 구현할 때 삽입은 insert(), 삭제는 erase() 메서드를 활용. 이때 erase() 메서드에는 삭제할 원소의 값이 올 수도 있고, 삭제할 원소의 주소가 올 수도 있음.
erase()에 주소를 인수로 받는 코드 예
#include <iostream>
#include <set>

using namespace std;

int main() {
  set<int> s = {1, 3, 2, 1, 5};

  // (1) 원소 4 삽입
  s.insert(4);
  // (2) 원소 2 삭제
  s.erase(2);

  // (3) 원소 4가 있는지 확인 후 삭제
  auto it = s.find(4);
  if (it != s.end()) {
    s.erase(it);
  }

  return 0;
}
셋은 삽입, 삭제할 때도 데이터 정렬 상태를 유지하며, erase() 메서드를 활용해 특정 값 혹은 특정 값의 위치 기준으로 삭제함.
주의해야 할 점은 erase() 메서드에 원소의 주소를 인수로 넘길 때 s의 원소 주소에 해당되지 않는 주소를 넘기면 프로그램이 정상적으로 동작하지 않음. (이거 index out of range, bound error를 말하는건가?)
(3) find 메서드를 활용해서 특정값이 있는지 확인할 때 end 반복자가 아닐 때만 erase() 메서드를 수행함. 그 이유는 end 반복자는 s가 가지고 있는 원소의 주소가 아니기 때문임. 만약 end 반복자 위치를 삭제하라고 하면 예외가 발생할 것임.
__맵
맵(map)은 키와 값을 쌍으로 갖는 컨테이너임. 여기서 키와 값의 쌍을 entry라고 하며 STL에서는 std:pair 타입으로 표현함. 내부는 균형 이진 탐색 트리로 구성되어 있기 때문에 항상 키 값을 기준으로 데이터가 자동 정렬됨. N개의 키가 있다면 키를 기준으로 검색, 삽입, 삭제를 하는데 시간 복잡도는 O(logN). (시간 복잡도는 엄밀하게 말해서 각 키의 비교 연산도 고려해야 하지만 상수로 가정했다고 함.)
맵의 키값은 중복되지 않고 유일함. 일반적인 배열은 인덱스로 원하는 값을 찾지만, 맵은 배열과 같이 정수형 인덱스로 한정되지 않고 키 자체를 통해 원하는 값을 찾을 수 있음.
맵의 선언 및 초기화맵을 쓰려면 #include <map>을 통해 맵 헤더를 포함시켜야 함.
[ ] 연산자는 표현상으로 배열과 비슷할 뿐더러 가독성도 좋으므로 많이 활용한다고 함. 다만 주의할 점은 배열과 다르게 [ ] 연산자를 통해 접근하려는 키가 맵에 없으면 맵에 현재 키를 추가한다는 것임. 다시 말해 맵에 없는 키에 접근하려고 하면 오류가 발생하는 것이 아니라 새로운 키가 만들어짐. [ ] 연산자의 시간 복잡도는 O(logN).
만약 특정 키를 검색할 때 키가 없고, 맵에 새로운 키를 추가하는 것이 아니라 키가 없는 상태를 유지해야 하면 find() 메서드를 사용합니다. find() 메서드는 키가 맵에 있으면 해당 키의 위치를 반환하고, 없으면 end 반복자를 반환합니다. find() 메서드의 시간 복잡도는 O(logN). 각 원소는 pair 객체이므로 멤버 변수로 first와 second를 가짐.
#include <iostream>
#include <map>

using namespace std;

int main() {
 // 맵 생성
 map<string, int> studentScores;

 // 키-값 쌍 추가
 studenScores["Alice"] = 95;
 studentScores["Bob"] = 88;
 studentScores["Charlie"] = 92;

 // [] 연산자를 사용하여 키에 접근 - 키가 있는 경우
 int score1 = studnetScores["Alice"];
 cout << score1 << endl; // (1) 출력값 : 95

 // [] 연산자를 사용하여 키에 접근 - 키가 없는 경우
 int score1 = studnetScores["rabbit"]; // (2)
 cout << score2 << endl; // 출력값 : 0

 // find() 메서드를 사용하여 키에 접근
 auto it = studentScores.find("Charlie"); // (3)
 if (it != studentScores.end()) {
   int score3 = it->second;
   cout << score3 << endl; // 출력값 : 92
 }
  return 0;
 }
맵의 값 변경
맵의 값을 변경할 때는 벡터와 마찬가지로 '[ ]' 연산자를 활용함. 인덱스가 숫자가 아닐 수도 있다는 것만 기억하면 됨.
#include <iostream>
#include <map>

using namespace std;

int main() {
  map<string, int> myMap = {{"Apple", 1}, {"Banana", 2}, {"Cherry", 3}};
  // "Banana" 키에 해당하는 값을 10으로 수정
  myMap["Banana"] = 10;

  return 0;
}
맵의 삽입과 삭제
맵에 원소를 삽입하는 방법은 2가지.(1) insert() 메서드 활용(2) [ ] 연산자 활용
인수로 pair 객체를 받는데, 이때 make_pair() 함수를 쓰거나 { }를 사용.
삭제할 때는 erase() 메서드를 사용. 인수로 키값 혹은 키의 위치를 넣으면 해당 키 혹은 위치의 원소가 삭제됨.
삽입 연산과, 인수로 값을 넘길 때의 시간 복잡도는 O(logN). 위치를 넘길 때의 시간 복잡도는 O(1).
#include <iostream>
#include <map>

using namespace std;

int main() {
  map<int, string> myMap;

  // (1) 삽입
  myMap.insert(make_pair(1, "Apple"));
  myMap.insert({2, "Banana"});
  myMap[3] = "Cherry";

  for (const auto &pair : myMap) {
   cout << pair.first << ": " << pair.second << endl;
  }
 /*
   1: Apple
   2: Banana
   3: Cherry
 */

 // (2) 삭제
 myMap.erase(2);

 for (const auto &pair : myMap) {
   cout << pair.first << ": " << pair.second << endl;
 }
 /*
   1: Apple
   3: Cherry
 */

 auto it = myMap.find(3);
 if (it != myMap.end()) {
   myMap.erase(it);
 }

 // 삭제 후 맵 출력
 for (const auto &pair : myMap) {
   cout << pair.first << ": " << pair.second << endl;
 }
 // 1: Apple

 return 0;
}
__정렬되지 않은 셋과 맵
기본적으로 C++ STL의 셋과 맵은 내부 구조가 이진 탐색 트리이기 때문에 정렬 상태를 유지함. 하지만 자동으로 정렬되는 것이
무조건 좋은 것만은 아님. 문제를 풀 때 굳이 필요 없는데도 정렬을 하면 성능 저하를 가져옴.
C++에서는 이때 사용할 수 있는 정렬되지 않은 셋(unordered_set) 과 정렬되지 않은 맵 (unordered_map)을 제공함.
이 둘은 기본적으로 앞에서 배운 셋, 맵과 같은 방법으로 사용할 수 있음. 다만 내부 구조가 이진 탐색 트리가 아닌 해시 기반이기 때문에 데이터를 자동으로 정렬하지 않음. 따라서 삽입, 삭제, 탐색의 시간 복잡도가 O(1)임. 최악의 경우엔 O(N)이지만 이런 경우는 거의 발생하지 않는다고 함. 기존에 제공했던 셋과 맵이 O(logN)이었던 것에 비해 빠르다고 할 수 있음.
정렬되지 않은 셋을 사용하려면 #include<unordered_set>을 추가하면 되고, 정렬되지 않은 맵을 사용하려면 #include<unordered_map>을 추가하면 됨. 비정렬 셋&맵의 사용법은 셋과 맵의 사용 방법과 동일함.
#include <iostream>
#include <unordered_set>

using namespace std;

int main() {
  unordered_set<int> myUnorderedSet;

  // 삽입
  myUnorderedSet.insert(3);
  myUnorderedSet.insert(1);
  myUnorderedSet.insert(4);
  myUnorderedSet.insert(2);

  for (int num : myUnorderedSet) {
    cout << num << " ";
  }
  cout << endl;

  // 출력값 : 2 4 1 3
  return 0;
}
이 함수는 시작 반복자부터 끝 반복자까지 범위에서 3번째 인수로 받은 값이 원소로 몇 개 들어가 있는지를 반환함.
#include <iostream>
#include <vector>
#include <algorithm>

using namespace std;

int main() {
  vector<int> v = {1, 4, 3, 4, 5, 4, 5};

  // 5라는 값이 벡터 v에 몇 번 나타나는지 세기
  int ret = count(v.begin(), v.end(), 5);

  cout << ret << endl; // 2

  return 0;
}
(1) 인수를 2개 받을 때는 시작 반복자와 끝 반복자를 받아 범위 내 원소들을 오름차순으로 정렬함.
(2) 인수를 3개 받을 때는 시작 반복자, 끝 반복자에 추가로 비교 함수를 받음. 비교 함수를 기준으로 범위 내 원소를 정렬.
사용자가 정의한 타입의 원소를 정렬하려면 sort() 함수를 활용해야 함. sort()의 시간 복잡도는 O(NlogN).
#include <algorithm>
#include <iostream>
#include <vector>

using namespace std;

int main() {
  std::vector<int> v = {4, 2, 5, 3, 1};

  // (1) 벡터 v를 오름차순으로 정렬
  sort(v.begin(), v.end());
  // v의 상태 : 1 2 3 4 5

  // (2) 벡터 v를 내림차순으로 정렬
  sort(v.begin(), v.rend());
  // v의 상태 : 5 4 3 2 1

  return 0;
}
#include <algorithm>
#include <iostream>
#include <vector>

using namespace std;

struct Point {
  int x, y;

  Point(int x, int y) : x(x), y(y) {}
};

// 사용자 정의 비교 함수
bool compare(const Point &a, const Point &b) {
  if (a.x == b.x) {
    return a.y < b.y; // (1) x 좌표가 같으면 y 좌표가 작은 순서대로 정렬
  }
  return a.x < b.x; // (2) x 좌표가 작은 순서대로 정렬
}
int main() {
  vector<Point> points = {{3, 4}, {1, 2}, {3, 1}, {2, 5}};

  // points 벡터를 사용자 정의 기준으로 정렬
  sort(points.begin(), points.end(), compare);

  // 정렬된 벡터 출력
  for (const Point &p : points) {
    cout << "(" << p.x << ", " << p.y << ") ";
  }
  cout << endl;
  // 출력값 : (1, 2), (2, 5), (3, 1), (3, 4)

  return 0;
}
코드를 보면 3번째 인수로 비교 함수 compare()가 들어갔음.
sort() 함수에서 사용자 정의 비교 함수는 반환값이 false일 때 원소의 위치를 바꿈. 정리하면 x값이 작은 구조체 변수가 앞에 오고, x값이 같으면 y값이 작은 구조체 변수가 앞에 오도록 정렬하는 비교 함수임.
__C++ : next_permutation( ) 함수로 순열 생성, C# : (※ C#은 next_permutation이 내장되어 있지 않아 재귀함수로 직접 구현)
next_permutation() 함수는 가능한 모든 순열을 생성함. 인수는 시작 반복자와 끝 반복자 2개를 받음.
순열은 사전 순으로 생성하며 실제 범위 내 원소들의 위치가 변경됨. 가능한 순열이 있으면 true를 반환. 더 이상 가능한 순열이 없으면 false를 반환함.
가능한 모든 순열을 생성할 때 이 함수를 주로 사용하므로 코드 예처럼 while 내에서 함수를 호출하는 패턴이 많음.
데이터가 N개라면 각 순열을 생성할 때 최대 N/2번 만큼 원소 위치를 맞바꿀 수 있고, 순열은 최대 N!개 있으므로 모든 순열을 생성할 때 연산 횟수를 기준으로 시간 복잡도는 O(N*N!) 임.
#include <algorithm>
#include <iostream>
#include <vector>

using namespace std;

int main() {
   vector<int> v = {1, 2, 3};
   // 모든 가능한 순열 출력
   do {
     for (int i : v) {
       cout << i << " ";
    }
    cout << endl;
 } while (next_permutation(v.begin(), v.end()));

 return 0;
}

/*
출력값:
1 2 3
1 3 2
2 1 3
2 3 1
3 1 2
3 2 1
*/
next_permutation() 에서 가능한 모든 순열을 생성하려면 데이터가 사전순으로 정렬된 상태여야 함. 만약 데이터가 사전순으로 정렬된 상태가 아니라면 정렬을 한 후에 next_permutation()을 호출해야 함.
책에 데이터를 사전순으로 정렬하지 않은 코드로 수정하여 직접 실행해 결과를 확인해보기 바란다고 적혀있음.
코드를 보면 (1) 3은 컨테이너에 있는 값이므로 1을 반환하고, (2) 7은 컨테이너에 없는 값이므로 0을 반환했음.
__C++ : max_element( ), min_element( ) 함수로 최댓값, 최솟값 위치 구하기 , C# : + LINQ Max( ), Min( ) 메서드로 최댓값, 최솟값 구하기
max_element(), min_element() 함수는 컨테이너 내에서 최댓값, 최솟값의 위치를 반환함.
두 함수는 시작 반복자와 끝 반복자로 2개의 인수를 받음. 시간 복잡도는 데이터 개수가 N개일 때 O(N)임.
#include <iostream>
#include <vector>
#include <algorithm>

using namespace std;

int main() {
  vector<int> v = {1, 3, 5, 7, 3, 2, 4, 6};

  auto maxIt = max_element(v.begin(), v.end());
  auto minIt = min_element(v.begin(), v.end());

  cout << *maxIt << endl; // 7
  cout << *minIt << endl; // 1

  return 0;
}
__04-5 함수 및 메서드 (Method)
주요 내용과 코테를 위해 알아야 할 내용만 빠르게 공부하고 넘어가자고 쓰여있음.
__ 함수/메서드 정의 (값 전달, ref, out 매개변수 활용)
C++의 함수는 '반환 타입 함수명 (인수1, 인수2 ...)'와 같은 방식으로 정의. 만약 반환 값이 없다면 반환 타입에 void를 사용.
int func1(param1, param2..., paramN) {
  // 함수의 실행 코드
  // ...
  // ...
  return result; // 반환값
}
__ 함수/메서드 호출
함수를 정의했으면 함수를 호출할 수 있음. 함수를 호출할 때 매개변수가 있으면 func(a, b)와 같이 인수를 함께 전달함.
#include <iostream>

using namespace std;

int add(int num1, int num2) {
  return num1 + num2;
}

int main() {
  int a = 5;
  int b = 10;

  // add 함수를 호출하여 결과 출력
  cout << add(a, b) << endl; // 15
  return 0;
}
__04-6 코딩 테스트 코드 구현 노하우
습관이 되어야 하므로 코드 작성 때마다 적용해보기.
__조기 반환 (Early Return)
코드 실행 과정이 함수 끝까지 도달하기 전에 반환하는 기법. 이 방식은 코드 가독성을 높여줄 뿐만 아니라 예외를 조금 더 깔끔하고 빠르게 처리할 수 있음.
#include <iostream>

using namespace std;

// 주어진 수량과 가격에 따라 총 가격을 계산하는 함수
double total_price(int quantity, double price) {
  double total = quantity * price; // (1) total 계산
  if (total > 100) { // (2) total이 100보다 크면
    return total * 0.9; // (3) 조기 반환
  }

  return total;
}

...생략...(수많은 작업들)
int main() {
  cout << total_price(4, 50) << endl;
  return 0;
}
(1) total에 quantity * price를 대입. (2) total의 값이 100보다 큰 경우 (3) total에 0.9를 곱하고 반환함. 이렇게 하면 함수 자체를 조기에 종료할 수 있으므로 이후 예외에 대한 처리를 하지 않아도 됨.
__보호 구문 (Guard Clauses)
본격적인 로직을 진행하기 전 예외 처리 코드를 추가하는 기법. 예를 들어 조건문을 이용하여 초기 입력값이 유효한지 검사하고 그렇지 않으면 바로 함수를 종료하는 보호 구문을 쓸 수 있음.
#include <iostream>
#include <vector>

using namespace std;

// (1) 벡터의 값을 모두 더해서 N으로 나눈 값을 반환하는 함수
double get_avg(const vector<int>& arr, int N) {
  // (2) 벡터가 비어 있는 경우
  if (arr.empty()) {
    return -1;
  }

  // (3) N이 0인 경우
  if (N == 0) {
    return -1;
  }

  int sum = 0;
  for (int num : arr) {
    sum += num;
  }

  return sum / N;
 }
이렇게 구현한 코드는 보호 구문 이후 구현부에서 입력값에 대한 예외를 고려하지 않아도 되므로 보기 좋음.
추가로 이런 습관을 들이면 처음부터 예외를 고려할 수 있어 코드를 더 안전하게 작성할 수 있음. 코드를 보면 (1) 실제 벡터 값을 모두 더해 N으로 나누기 전에 (2) 벡터가 비었거나 (3) N이 0인 경우를 먼저 예외처리 함. 그러면 이후 코드에선 원하는 동작 구현에만 집중할 수 있음. 이런 코드 입력 습관은 직접 많이 구현해야 자기 것이 됨.
리마인드
기억 01. C++은 기본 타입(정수형, 문자형, 부동소수형)등을 제공하고 STL을 통해 다양한 컨테이너(벡터, 맵, 셋 등)와 알고리즘을 제공함.
기억 02. C++에서 함수는 '반환 타입 함수 이름(인수)'과 같은 형식으로 정의할 수 있음.
기억 03. 조기 반환, 보호 구문, 합성 함수 등의 기법을 활용하면 코드 가독성과 효율성을 높일 수 있음.
시간복잡도 (time complexity)란, 알고리즘의 성능을 나타내는 지표로, 입력 크기에 따른 연산 횟수를 의미.
( =알고리즘이 시작한 순간부터 결괏값이 나올 때까지의 연산 횟수)
시간 복잡도는 낮으면 낮을수록 좋다.
입력 크기 = 알고리즘이 처리해야 할 데이터양
ex)책장에 꽂힌 5권 책을 정리하는 문제 -> 입력 크기 : 5
__1차원 배열 검색하기
연산 횟수가 가장 적은 경우 = 검색 시작 위치에 찾을 값이 바로 있는 경우
연산 횟수가 가장 많은 경우 = 아예 찾으려는 값이 없거나 가장 마지막에 위치하는 경우
__알고리즘 수행 시간을 측정하는 방법
(1) 절대 시간 측정
프로그램 실행 후 결과 반영까지의 시간 측정. 그러나 테스트 환경에 따라 달라질 수 있어
코테에선 잘 활용 안 함.
(2) 시간 복잡도 측정
시간 복잡도 측정 결과는 최선(best), 보통(normal), 최악(worst)으로 나눔.
알고리즘 성능을 일반화할 수 없는 case (ex : 크기가 1인 배열) 가 있기 때문에, 시간 복잡도 측정 시 같은 상황을 고려해야함.
첫째, 최악의 경우를 기준으로 시간 복잡도를 분석.
= 빅오 표기법(big-O notation)
둘째, 알고리즘 성능은 정확한 연산횟수가 아닌, 추이를 활용.
= 점근적 표기법 = 충분히 큰 입력값 N(상한선)에 따른 연산 횟수의 추이를 활용해 시간 복잡도를 표현하는 방법.
상한선은 빅오 표기법, 하한선은 빅오메가 표기법으로 표시
__최악의 경우 시간 복잡도를 표현하는 빅오 표기법
= 프로그램 연산 횟수가 f(x) 일 때, (f(x)는 구현 코드의 연산 횟수를 일반화한 다항식)
= 입력값이 x일 때 연산 횟수
O(g(x)) = 최악의 시간 복잡도라고 가정하면, g(x)는 f(x)의 상한이다. 즉 어떠한 경우에도 g(x)가 f(x)보다 항상 크다는 것을 의미.
특정 x값 이후부터 항상 g(x)가 f(x)보다 큰 경우 라는 것 x 값이 충분히 큰 경우에는 항상 g(x)가 f(x)보다 크다는 것을 보장한다는 것. 따라서 이를 만족하면 상한이라고 해도 무리 없음.
함수 최고차항을 남기고 계수를 지워 O(...)와 같이 표기.
ex) 2x^2 + 3x + 5 는 O(x^2) 과 같이 표현.
차수(degree) : 다항식 변수를 거듭제곱한 지수, ax^n의 차수는 n, 차수 n을 갖는 항을 n차항
계수(coefficient) : 각 항에 곱하는 상수
최고차항 제거 우선순위 (y값 격차가 큰 순위?)
1. y = x! 팩토리얼
2. y = 2* 지수함수
3. y = x^2 다항함수
4. y = xlogx 로그함수와 다항함수 조합
5. y = x 다항함수
6. y = logx 로그함수
7. y = 1 상수
상한을 구할 때는 f(x)에서 y값이 가장 크게 증가하는 x^2 만 고려하면 됨.
상한 = g(x)가 f(x)보다 커지게 하는 장치일 뿐임. 최고차항이 아닌 함수는 지움.
__시간 복잡도를 코딩 테스트에 활용하는 방법
= 시간 복잡도를 활용하여 제한 시간 내에 문제를 해결할 수 없는 알고리즘 제외시키기.
ex) 컴퓨터가 초당 연산할 수 있는 최대 횟수는 1억 번이다. -> 1000~3000만 정도로 연산 횟수 고려 가능
외울 필요 X. 연산 횟수 간격이 매우 큰 이유는 문제에서 요구하는 성틍에 동과하도록 충분히 여유를 두기 때문.
'이 정도 되는구나' 감을 잡으면 됨.
ex) '대략 데이터 1,000만 개 정도면 O(N)을 사용해야 하는구나.'
시간 복잡도 | 최대 연산 횟수
O(N!) | 10
O(2^n) } | 20~25
O(N^3) | 200~300
O(N^2)|3,000~5,000
O(NlogN) | 100만
O(N) | 1,000 ~ 2,000만
O(logN) | 10억
하나하나 되짚는다 -> O(N)
순서를 고려해서 N개를 뽑는 경우의 수 -> O(N!) = 순열 및 팩토리얼
입력 크기 1 증가 시 연산 횟수 2배 증가 -> O(2^N) = 부분 집합의 수(각 집합 원소로 부분 집합 만들면 원소 포함/미포함 두 가지 선택 가능) -> 원소가 N개인 집합에서 가능한 모든 부분 집합의 수는 2^N
크기가 N*N인 2차원 배열 순회 -> O(N^2)
크기가 N인 1차원 배열 순회 -> O(N)
이진 탐색 -> 1024개 원소가 있는 배열에서, 한 번 찾을 때마다 검색 범위가 반으로 줄기 때문에 2^10 = 1024, 즉 최대 10번만 탐색 시 원하는 원소를 찾을 수 있다. -> 한 번 연산 시 작업량 반으로 줄어듬. 코테에서 로그 밑이 없으면 대부분 2라고 생각하기.
배열의 특정 위치에 임의 접근 or 수학 공식이 있어서 어떤 N이든 공식으로 한번에 구할 수 있다. -> O(1)
__03-2 시간 복잡도 계산해보기
(1) 문제 정의 (2) 연산 횟수 측정 (3) 시간 복잡도 분석 순서
__별 찍기 문제
: 숫자 N을 입력받으면 N번째 줄까지 별을 1개부터 N개까지 늘려가며 출력.
ex) N = 3
*
**
***
N이 N+1씩 증가하고, 연산 횟수 = 별이 찍히는 각 줄의 별 개수에 대한 총합(모든 줄의 별 개수)
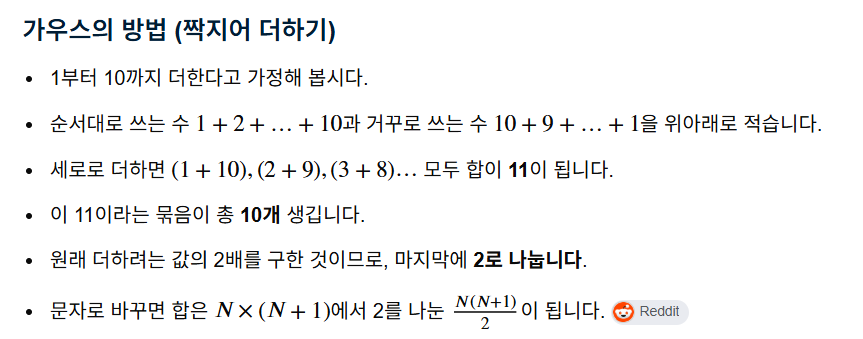
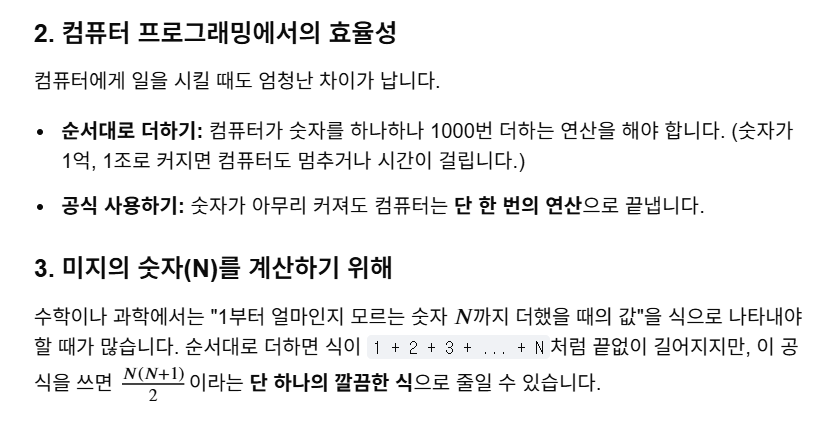
= f(N) = 1+2+...+ N = N(N+1)/2 = N(N+1)/2은 1부터 N까지의 자연수를 모두 더한 값을 구하는 공식
= 시간 복잡도는 O(N^2)
출처 : Google 검색 Gemini 답변
__박테리아 수명 문제
초기 박테리아 세포 개수가 N일 때 해마다 세포 개수가 이전 세포 개수의 반으로 준다면 언제 모든 박테리아가 죽을지 계산.
ex) N이 16인 경우 모든 박테리아가 5년이면 소멸. 16 8 4 2 1 0(5년) = 소멸
현재 박테리아 수가 N이라면 1년 뒤의 박테리아 수는 1/2 * N.Y년 후의 박테리아 수는 (1/2)^Y * N
특정 값을 계속 반씩 줄어드니까 시간복잡도가 O(logN)임을 유추할 수 있음.
수식을 풀어 쓰자면, 박테리아 소멸 시기는 (1/2)^Y * N 값이 최초로 1보다 작아질 때. 수식으로는 (1/2)^Y * N <= 1인 Y를 찾으면 됨. (1/2)^Y * N 의 양변을 N으로 나누면 (1/2)^Y <= 1/N. 양변 역수 취하고 부등호를 바꾸면 2^Y >= N.
시리즈 작성 목적 : 해당 C++ 교재를 기반으로 C#과 C++ 학습 내용을 동시에 정리.
전자책 앱으로 무료로 볼 수 있고, C#보다 C++ 교재가 시중에 더 잘 나와있는 편인데다, C#으로 코딩테스트를 준비하더라도 C++도 중요하니까 C#과 C++ 을 함께 공부하기로 했다. 코딩테스트 관련 학습내용은 어떤 언어든 대체로 다루는 내용은 한정적인 편이고, 솔직히 책에서 다루는 문제만 잘 풀이하고 복습해도 테스트를 치루는 데에는 충분히 문제 없어보인다. 꾸준히 잘 하는 게 더 중요한 것 같다.
게시물은 책의 목차 단위로 작성하되, 각 게시물마다 다루는 개념이 C#과 C++ 언어 내에서 유사한 항목들을 정리하여 작성할 것이다. 게시물 작성할 때마다 여기에서 사이트맵처럼 바로 필요한 목차 내용으로 이동할 수 있게 할 계획이다. 내용은 03장부터 정리할 것이다.
03장 알고리즘의 효율 분석
__03-1 시간 복잡도란? __1차원 배열 검색하기 __알고리즘 수행 시간을 측정하는 방법 __최악의 경우 시간 복잡도를 표현하는 빅오 표기법 __시간 복잡도를 코딩 테스트에 활용하는 방법 __03-2 시간 복잡도 계산해보기 __별 찍기 문제 __박테리아 수명 문제
04장 코딩 테스트 필수 문법 __04-1 빌트인 데이터 타입 __정수형 __부동소수형 __문자열 __04-2 STL __STL __STL과 자주 사용하는 필수 문법 __반복자 __04-3 STL의 컨테이너 __벡터 __셋 __맵 __정렬되지 않은 셋과 맵 __04-4 STL의 알고리즘 __count( ) 함수로 횟수 세기 __sort( ) 함수로 정렬하기 __next_permutation( ) 함수로 순열 생성하기 __unique( ) 함수로 중복 정리하기 __binary_search( ) 함수로 이진 탐색하기 __max_element( ), min_element( ) 함수로 최댓값, 최솟값 위치 구하기 __04-5 함수 __함수 정의 __함수 호출 __04-6 코딩 테스트 코드 구현 노하우 __조기 반환 __보호 구문
[둘째 마당 : 코딩 테스트 완전 정복]
05장 배열 __05-1 배열 개념 __배열 선언 __배열과 차원 __05-2 배열의 효율성 __배열 연산의 시간 복잡도 __배열을 선택할 때 고려할 점 __05-3 몸풀기 문제 __[문제 01] 배열 정렬하기★ __[문제 02] 배열 제어하기★★ __05-4 합격자가 되는 모의 테스트 __[문제 03] 두 수를 뽑아서 더하기★ __[문제 04] 모의고사★ __[문제 05] 행렬의 곱셈★ __[문제 06] 실패율★★ __[문제 07] 방문 길이★★
06장 스택 __06-1 스택 개념 __스택의 동작 원리 이해하기 __06-2 스택의 정의 __스택의 ADT __06-3 몸풀기 문제 __[문제 08] 괄호 짝 맞추기★★ __[문제 09] 10진수를 2진수로 변환하기★ __06-4 합격자가 되는 모의 테스트 __[문제 10] 괄호 회전하기★ __[문제 11] 짝지어 제거하기★ __[문제 12] 주식 가격★★ __[문제 13] 크레인 인형 뽑기 게임★★ __[문제 14] 표 편집★★★★★
07장 큐 __07-1 큐의 개념 __큐에서 데이터가 이동하는 과정 살펴보기 __큐의 특성을 활용하는 분야 __큐의 ADT __07-2 몸풀기 문제 __[문제 15] 요세푸스 문제★★ __07-3 합격자가 되는 모의 테스트 __[문제 16] 기능 개발★★ __[문제 17] 카드 뭉치★★
08장 해시 __08-1 해시의 개념 __해시 자세히 알아보기 __해시의 특성을 활용하는 분야 __08-2 해시 함수 __해시 함수를 구현할 때 고려할 내용 __자주 사용하는 해시 함수 알아보기 __08-3 충돌 처리 __체이닝으로 처리하기 __개방 주소법으로 처리하기 __08-4 몸풀기 문제 __[문제 18] 두 개의 수로 특정값 만들기★ __[문제 19] 문자열 해싱을 이용한 검색 함수 만들기★★ __08-5 합격자가 되는 모의 테스트 __[문제 20] 완주하지 못한 선수★ __[문제 21] 영어 끝말잇기★ __[문제 22] 전화번호 목록★★ __[문제 23] 할인 행사★★ __[문제 24] 오픈 채팅방★★ __[문제 25] 베스트 앨범★★ __[문제 26] 신고 결과 받기★★ __[문제 27] 메뉴 리뉴얼★★★
09장 트리 __09-1 트리 개념 __나무를 거꾸로 뒤집어 놓은 모양의 트리 __09-2 이진 트리 표현하기 __배열로 표현하기 __이진 트리 순회하기 __포인터로 표현하기 __인접 리스트로 표현하기 __09-3 이진 트리 탐색하기 __이진 탐색 트리 구축하기 __이진 탐색 트리 탐색하기 __이진 탐색 트리와 배열 탐색의 효율 비교 __09-4 몸풀기 문제 __[문제 28] 트리 순회★ __[문제 29] 이진 탐색 트리 구현★ __09-5 합격자가 되는 모의 테스트 __[문제 30] 예상 대진표★ __[문제 31] 다단계 칫솔 판매★★ __[문제 32] 길 찾기 게임★★★★
10장 집합 __10-1 집합과 상호배타적 집합의 개념 __집합의 개념 __상호배타적 집합의 특성을 활용하는 분야 __10-2 집합의 연산 __배열을 활용한 트리로 집합 표현하기 __유니온-파인드 알고리즘 __10-3 몸풀기 문제 __[문제 33] 간단한 유니온-파인드 알고리즘 구현하기★★ __10-4 합격자가 되는 모의 테스트 __[문제 34] 폰켓몬★ __[문제 35] 섬 연결하기★★★
11장 그래프 __11-1 그래프의 개념 __그래프 용어 정리 __그래프의 특징과 종류 __그래프 구현 __11-2 그래프 탐색 __깊이 우선 탐색 __너비 우선 탐색 __깊이 우선 탐색과 너비 우선 탐색 비교 __11-3 그래프 최단 경로 구하기 __다익스트라 알고리즘 __벨만-포드 알고리즘 __11-4 몸풀기 문제 __[문제 36] 깊이 우선 탐색 순회★ __[문제 37] 너비 우선 탐색 순회★ __[문제 38] 다익스트라 알고리즘★★★ __[문제 39] 벨만-포드 알고리즘★★★ __11-5 합격자가 되는 모의 테스트 __[문제 40] 미로 탈출★★ __[문제 41] 게임 맵 최단 거리★★ __[문제 42] 네트워크★★ __[문제 43] 양과 늑대★★★★★ __[문제 44] 배달★★★ __[문제 45] 경주로 건설★★★★★ __[문제 46] 전력망을 둘로 나누기★★
12장 백트래킹 __12-1 백트래킹과 백트래킹 알고리즘 개념 __백트래킹이란? __백트래킹 알고리즘이란? __유망 함수란? __백트래킹 알고리즘 문제에 적용해보기 __N-퀸 문제 __12-2 몸풀기 문제 __[문제 47] 1부터 N까지 숫자 중 합이 10이 되는 조합 구하기★ __[문제 48] 스도쿠 퍼즐★★★ __12-3 합격자가 되는 모의 테스트 __[문제 49] 피로도★ __[문제 50] N-퀸★ __[문제 51] 양궁 대회★★ __[문제 52] 외벽 점검★★★★★ __[문제 53] 사라지는 발판★★★★★
13장 정렬 __13-1 정렬 개념 __정렬이 필요한 이유 __삽입 정렬 __병합 정렬 __힙 정렬 __우선순위 큐 __계수 정렬 __위상 정렬 __13-2 몸풀기 문제 __[문제 54] 계수 정렬 구현하기★ __[문제 55] 정렬이 완료된 두 배열 합치기★ __13-3 합격자가 되는 모의 테스트 __[문제 56] 문자열 내 마음대로 정렬하기★ __[문제 57] 정수 내림차순으로 배치하기★ __[문제 58] K번째 수★ __[문제 59] 가장 큰 수★★★ __[문제 60] 튜플★★ __[문제 61] 지형 이동★★★★
14장 시뮬레이션 __14-1 시뮬레이션 문제 풀이 노하우 __시뮬레이션 문제를 푸는 방법 __행렬 연산 __좌표 연산 __대칭, 회전 연산 __14-2 몸풀기 문제 __[문제 62] 배열 회전하기★★ __[문제 63] 두 행렬을 곱한 후 전치 행렬 만들기★ __[문제 64] 달팽이 수열 만들기★★ __14-3 합격자가 되는 모의 테스트 __[문제 65] 이진 변환★★ __[문제 66] 롤케이크 자르기★★ __[문제 67] 카펫★★ __[문제 68] 점프와 순간 이동★★ __[문제 69] 캐릭터의 좌표★★
15장 동적 계획법 __15-1 동적 계획법 개념 __점화식 세우기와 동적 계획법 __재귀 호출의 횟수를 줄여주는 메모이제이션 __최장 증가 부분 수열 __최장 공통 부분 수열 __15-2 몸풀기 문제 __[문제 70] LCS 길이 계산하기★★★ __[문제 71] LIS 길이 계산하기★★★ __[문제 72] 조약돌 문제★★★ __15-3 합격자가 되는 모의 테스트 __[문제 73] 피보나치 수★ __[문제 74] 2 × n 타일링★ __[문제 75] 정수 삼각형★★ __[문제 76] 땅따먹기★★ __[문제 77] 도둑질★★★★★ __[문제 78] 가장 큰 정사각형 찾기★★★ __[문제 79] 단어 퍼즐★★★★
16장 그리디 __16-1 그리디 개념 __그리디 알고리즘으로 거스름돈 내어주기 __그리디 알고리즘이 최적해를 보장하려면? __16-2 최소 신장 트리 __신장 트리란? __최소 신장 트리란? __16-3 배낭 문제 __짐을 쪼갤 수 있는 부분 배낭 문제 __짐을 쪼갤 수 없는 0/1 배낭 문제 __16-4 몸풀기 문제 __[문제 80] 거스름돈 주기★★ __[문제 81] 부분 배낭 문제★★ __16-5 합격자가 되는 모의 테스트 __[문제 82] 예산★ __[문제 83] 구명보트★ __[문제 84] 귤 고르기★★ __[문제 85] 기지국 설치★★
[부록 1 : 모의고사]
_01회 모의고사 __[문제 86] 미로 탈출 명령어 __[문제 87] 택배 배달과 수거하기 __[문제 88] 개인 정보 수집 유효기간 _02회 모의고사 __[문제 89] 110 옮기기 __[문제 90] 쿼드 압축 후 개수 세기 __[문제 91] 없는 숫자 더하기 _03회 모의고사 __[문제 92] 불량 사용자 __[문제 93] k진수에서 소수 개수 구하기 __[문제 94] 거리두기 확인하기 _04회 모의고사 __[문제 95] 코딩 테스트 공부 __[문제 96] 두 큐 합 같게 만들기 __[문제 97] 숫자 게임 _05회 모의고사 __[문제 98] 보석 쇼핑 __[문제 99] 파괴되지 않은 건물 __[문제 100] 로또의 최고 순위와 최저 순위